Haiku 5.5 chegou: custa o mesmo que o GPT-6 Luna, até o pedido passar de 100 mil tokens
A Anthropic cortou 90% do preço do Haiku e empatou com a OpenAI na faixa de pedidos curtos. Acima de 100 mil tokens a tabela sobe cinco vezes. No chat do nosso site, a mesma conversa ficou sete vezes mais barata, com dois tropeços que o anúncio não conta.


A Anthropic lançou o Claude Haiku 5.5 em 7 de outubro de 2026. Em pedidos de até 100 mil tokens ele custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 de saída, 90% menos que o Haiku 4.5 e exatamente o preço do GPT-6 Luna, da OpenAI. Acima de 100 mil tokens o preço sobe para US$ 0,50 e US$ 2,50, cinco vezes mais, e o Luna passa a sair bem mais barato. Nos números da Anthropic, o Haiku 5.5 deixa o 4.5 muito para trás (72,4% contra 15,7% no uso de computador), vence o Luna nas seis provas em comum e fica abaixo do Sonnet 5.5 em todas. No chat de atendimento da ROO3, a mesma conversa custou cerca de sete vezes menos e respondeu mais rápido, mas o modelo recusou uma tarefa interna que o 4.5 fazia sem problema.
O que você leva deste artigo
- O identificador claude-haiku-5-5 está no catálogo oficial da Anthropic desde 7 de outubro de 2026, sem data no nome e sem apelido.
- Até 100 mil tokens por pedido: US$ 0,10 de entrada, US$ 0,50 de saída e US$ 0,01 na leitura de cache. O mesmo preço do GPT-6 Luna.
- Acima de 100 mil tokens o preço sobe cinco vezes. Na geração atual da Anthropic, é o único modelo com preço por tamanho de pedido.
- Contra o Haiku 4.5, o salto aparece em todas as provas: de 0,0% para 39,2% no Terminal-Bench 4.0 e de 15,7% para 72,4% no OSWorld 2.1.
- É o primeiro Haiku com nível de esforço. Em duas de quatro provas, o Sonnet 5.5 em high tira nota maior que o Haiku 5.5 no máximo e custa menos por tarefa.
- No teste no chat da ROO3, o custo por fala caiu de US$ 0,0032 para US$ 0,00045, e o modelo novo recusou o resumo interno que o 4.5 fazia.
- Medição independente, por enquanto, só a do LiveBench: 72,1, praticamente empatado com o GPT-6 Luna (72,0).
O que saiu, e onde já dá para usar
O Claude Haiku 5.5 saiu em 7 de outubro de 2026 e fecha a família 5.5 da Anthropic, depois do Opus 5.5, em 22 de setembro, e do Sonnet 5.5, em 28 de setembro. É o modelo pequeno da casa, feito para o trabalho que roda em volume: classificar mensagem, resumir, extrair dado de documento, responder cliente e servir de ajudante para um modelo maior. A Anthropic diz que é o modelo mais rápido que ela já lançou na velocidade padrão.
O identificador claude-haiku-5-5 está na documentação oficial, com preço publicado, e o modelo já roda na API da Anthropic, na Amazon Bedrock, no Google Cloud, no Microsoft Foundry e na Claude Platform on AWS. O nome não tem data no fim nem apelido, e a empresa se compromete a manter o modelo disponível pelo menos até 7 de outubro de 2027.
A ficha técnica subiu de patamar. A janela de contexto passou de 200 mil para 1 milhão de tokens, a resposta máxima de 64 mil para 128 mil, e o conhecimento confiável vai até junho de 2026. É também o primeiro Haiku com o botão de esforço, os cinco níveis que o Sonnet e o Opus já tinham. O padrão é medium.
O anúncio trouxe mais duas novidades que mexem na conta de quem usa a API. A leitura de cache do Sonnet 5.5 caiu pela metade, de US$ 0,20 para US$ 0,10 por milhão de tokens, o que deixa o Sonnet cerca de 20% mais barato na maior parte do trabalho com agentes, pela conta da Anthropic. E os assinantes Max e Team passam a receber, a partir desta semana, crédito mensal para a API: US$ 100 no Max 5x, US$ 200 no Max 20x e até US$ 500 no Team, divididos entre os usuários.
A tabela da Anthropic, com sete provas
A comparação escolhida pela Anthropic põe o Haiku 5.5 ao lado do Haiku 4.5, do GPT-6 Luna, o modelo barato que a OpenAI lançou em 22 de setembro, e do Sonnet 5.5, que entra como referência. Os números do Haiku 5.5 são todos no esforço máximo, com média de cinco rodadas.
Contra o antecessor, o salto aparece em tudo o que foi medido. No Terminal-Bench 4.0, que mede trabalho longo em linha de comando, o Haiku 4.5 fez 0,0% e o novo fez 39,2%. No OSWorld 2.1, em que o modelo opera um computador para cumprir tarefas de várias etapas, foi de 15,7% para 72,4%. Na leitura de gráfico, de 6,4% para 46,4%.
Contra o Luna, o Haiku 5.5 vence as seis provas em que os dois aparecem, com a maior distância no uso de computador: 72,4% contra 48,9%. Esse número do Luna foi rodado pela própria Anthropic, pela API da OpenAI, nas mesmas 82 tarefas. Não foi publicado pela OpenAI.
| Haiku 5.5 novo | Haiku 4.5 | GPT-6 Luna OpenAI | Sonnet 5.5 referência | |
|---|---|---|---|---|
| Trabalho de escritório GDPval-AA v2.1, nota Elo | 1.620 | 735 | 1.437 | 1.840 |
| Projetos longos de escritório AA-Briefcase v1.1, nota Elo | 1.578 | 614 | 1.336 | 1.824 |
| Uso de computador OSWorld 2.1, subconjunto offline | 72,4% | 15,7% | 48,9% | 83,9% |
| Conhecimento difícil Humanity's Last Exam, sem ferramentas | 45,9% | 10,2% | não publicado | 56,9% |
| Conhecimento difícil Humanity's Last Exam, com ferramentas | 57,4% | 18,7% | não publicado | 64,5% |
| Trabalho longo em terminal Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| Programação FrontierCode 1.1, conjunto Main | 46,4% | não publicado | 42,4% | 52,1% |
| Leitura de gráfico Chartography, sem ferramentas | 46,4% | 6,4% | 29,1% | 61,6% |
O Sonnet 5.5 fica na frente em todas as linhas, e está na tabela justamente para mostrar a distância. A menor é na programação do FrontierCode, com 46,4% contra 52,1%. O relatório técnico traz um detalhe que o anúncio não destaca: com os dois no esforço máximo, o Haiku faz 46,4% e o Sonnet, 46,2%. O Sonnet só abre vantagem rodando em xhigh.
Os depoimentos que a Anthropic escolheu falam de velocidade e volume. A HubSpot diz que o Haiku 5.5 tirou 92,8% no conjunto de testes de CRM dela, o melhor resultado que já viu ali. A AlphaSense, que faz cerca de 8 milhões de chamadas por semana numa função de perguntas sobre documentos, mediu 0,84 contra 0,76 do Haiku 4.5 em 400 consultas. A Box contou 11 pontos a mais com mais ou menos metade da latência. São empresas convidadas a testar antes do lançamento.
O preço: igual ao do GPT-6 Luna até 100 mil tokens
Em pedidos de até 100 mil tokens, o Haiku 5.5 custa US$ 0,10 por milhão de tokens de entrada, US$ 0,50 de saída e US$ 0,01 na leitura de cache. O Haiku 4.5 cobra US$ 1, US$ 5 e US$ 0,10. O corte é de 90% em cada linha. Em lote, metade: US$ 0,05 e US$ 0,25.
A página de preços da OpenAI lista para o GPT-6 Luna os mesmos três números, centavo por centavo. É a segunda vez em duas semanas que as duas empresas chegam à mesma tabela, porque o Sonnet 5.5 já custava o mesmo que o GPT-6 Sol. Na faixa barata, o empate depende do tamanho do pedido.
Acima de 100 mil tokens, o Haiku 5.5 passa a cobrar US$ 0,50 de entrada e US$ 2,50 de saída, cinco vezes mais. O Luna segura o preço até 272 mil tokens de entrada e, acima disso, cobra US$ 0,20 e US$ 0,75. Entre 100 mil e 272 mil tokens, o Haiku sai cinco vezes mais caro por token que o concorrente. E é o único modelo da geração atual da Anthropic com preço por faixa: o Sonnet e o Opus cobram a mesma tabela até 1 milhão de tokens.
| Haiku 5.5 novo | Haiku 4.5 | GPT-6 Luna OpenAI | Sonnet 5.5 | |
|---|---|---|---|---|
| Pedido de até 100 mil tokens entrada / saída | US$ 0,10 / US$ 0,50 | US$ 1 / US$ 5 | US$ 0,10 / US$ 0,50 | US$ 2 / US$ 10 |
| De 100 mil a 272 mil tokens entrada / saída | US$ 0,50 / US$ 2,50 | US$ 1 / US$ 5, até 200 mil | US$ 0,10 / US$ 0,50 | US$ 2 / US$ 10 |
| Acima de 272 mil tokens entrada / saída | US$ 0,50 / US$ 2,50 | não cabe | US$ 0,20 / US$ 0,75 | US$ 2 / US$ 10 |
| Leitura de cache pedido de até 100 mil tokens | US$ 0,01 | US$ 0,10 | US$ 0,01 | US$ 0,10 |
| Processamento em lote até 100 mil tokens, entrada / saída | US$ 0,05 / US$ 0,25 | US$ 0,50 / US$ 2,50 | US$ 0,05 / US$ 0,25 | US$ 1 / US$ 5 |
A Anthropic justifica a faixa com um dado do próprio uso: 90% dos pedidos feitos ao Haiku 4.5 tinham até 100 mil tokens. Para essa maioria, a conta despenca. Quem manda contrato inteiro, manual de produto ou histórico longo de conversa em cada pedido fica com um desconto de 50% sobre o 4.5, e com o Luna mais barato.
Tem ainda a diferença de régua. O Haiku 5.5 usa o divisor de texto que a Anthropic adotou a partir do Opus 4.7, que conta o mesmo texto como cerca de 30% mais tokens. Somando as duas coisas, a empresa calcula que o Haiku 5.5 sai, em média, uns 75% mais barato que o 4.5 para o mesmo trabalho, e não 90%. Se o assunto é novo para você, o artigo sobre o que é token e janela de contexto explica a conta.
O desconto de 90% vale para nove em cada dez pedidos que o Haiku 4.5 recebia. Para o décimo, o concorrente da OpenAI ficou mais barato.
O botão de esforço, e onde o Haiku no máximo deixa de compensar
No Haiku 4.5, a única regulagem era ligar o pensamento e dar a ele um orçamento de tokens. O 5.5 ganhou os cinco níveis de esforço: low, medium, high, xhigh e max. Mais esforço quer dizer mais raciocínio antes da resposta, mais tokens e mais tempo. Junto com o anúncio, a Anthropic publicou nota e custo por tarefa de cada nível em quatro provas, com o Sonnet 5.5 no mesmo gráfico e, em duas delas, o GPT-6 Luna.
Lendo os gráficos ponto a ponto, aparece o mesmo efeito que vimos no Sonnet 5.5 nove dias atrás, agora um degrau abaixo. Em duas das quatro provas, o Sonnet 5.5 no esforço high tira nota maior que o Haiku 5.5 no máximo e custa menos por tarefa.
| Haiku 5.5 medium, o padrão | Haiku 5.5 max | Sonnet 5.5 high | GPT-6 Luna max | |
|---|---|---|---|---|
| Uso de computador OSWorld 2.1, subconjunto offline | 53,3% · US$ 0,13 | 72,4% · US$ 0,61 | 73,2% · US$ 1,38 | 48,9% · US$ 0,20 |
| Trabalho de escritório GDPval-AA v2.1, nota Elo | 1.277 · US$ 0,03 | 1.620 · US$ 0,87 | 1.551 · US$ 0,62 | 1.437 · US$ 0,09 |
| Conhecimento difícil Humanity's Last Exam, sem ferramentas | 35,5% · US$ 0,007 | 45,9% · US$ 0,21 | 47,9% · US$ 0,08 | não publicado |
| Trabalho longo em terminal Terminal-Bench 4.0, custo por tentativa | 20,3% · US$ 0,68 | 39,2% · US$ 2,64 | 43,0% · US$ 1,46 | não publicado |
O Terminal-Bench é o caso mais claro. O Haiku no máximo faz 39,2% gastando US$ 2,64 por tentativa, e o Sonnet em high faz 43,0% por US$ 1,46. O próprio anúncio diz que, para programação complexa com agentes, o Sonnet e o Opus continuam sendo a escolha certa. No Humanity's Last Exam, o Sonnet em high passa o melhor resultado do Haiku gastando US$ 0,08 contra US$ 0,21.
Nas outras duas provas o Haiku segura o lugar dele. No uso de computador, ele no máximo fica a 0,8 ponto do Sonnet em high custando menos da metade. No GDPval-AA, que avalia trabalho profissional em 44 ocupações, ele no máximo passa o Sonnet em high, mas gasta 40% a mais por tarefa.
Contra o Luna, depende do nível. No uso de computador, o Haiku no medium, que é o padrão, já faz 53,3% por US$ 0,13, mais nota por menos dinheiro que o Luna no máximo. No GDPval-AA os dois andam juntos: o Haiku em high faz 1.420 pontos por US$ 0,09, e o Luna no máximo faz 1.437 pelos mesmos US$ 0,09. Nos níveis baixos o Luna gasta menos e tira menos: no low, 1.036 pontos por US$ 0,004, contra 1.125 por US$ 0,01 do Haiku.
A regra que sai desses pontos é fácil de aplicar. O Haiku 5.5 rende melhor do low ao high. Se a tarefa só fica boa em xhigh ou max, rode a mesma tarefa no Sonnet 5.5 em medium ou high antes de decidir, porque pode sair melhor e mais barato.
No Terminal-Bench, o modelo mais barato da Anthropic, rodando no máximo, gasta quase o dobro do Sonnet em high e entrega menos.
Testamos no chat do nosso site no dia do lançamento
O site da ROO3 tem um chat de atendimento que conversa com quem chega, entende o problema e passa o contato para o WhatsApp com um resumo pronto para o Rodrigo. Ele foi construído sobre o Haiku 4.5. No dia do lançamento, rodamos as mesmas conversas no Haiku 5.5, com chamada real à API, para medir custo, tempo e comportamento antes de mexer em produção.
O custo caiu do jeito que a tabela promete. Na mesma fala do chat, o Haiku 4.5 gastou US$ 0,0032 e o 5.5 gastou US$ 0,00045, cerca de sete vezes menos. No roteiro de diagnóstico, que usa uma ferramenta para registrar as respostas, a fala foi de US$ 0,0080 para US$ 0,00095, e o tempo de resposta caiu de 5,3 para 1,9 segundos. O divisor de texto novo também apareceu na medição: o mesmo histórico de conversa deu 3.856 tokens no 5.5 e 2.950 no 4.5, 31% a mais, praticamente os 30% que a documentação avisa.
O primeiro tropeço veio no resumo. No fim da conversa, o sistema pede ao modelo um resumo para a equipe, e esse pedido ia como mensagem dentro da própria conversa de atendimento. O Haiku 4.5 sempre obedeceu. O 5.5 escreveu uma fala para o visitante dizendo que não ia montar aquele resumo e oferecendo o WhatsApp. Sem a correção, esse texto teria ido para o CRM no lugar do resumo.
O relatório técnico da Anthropic registra o mesmo traço: na auditoria automática de comportamento, o Haiku 5.5 recusou pedido legítimo mais vezes que qualquer outro modelo testado pela empresa, embora em pedidos simples, de uma mensagem só, tenha recusado menos que o 4.5. A correção no nosso código foi dar ao resumo um prompt próprio, de uso interno, com a conversa enviada como transcrição. Depois disso, os dois modelos fizeram o resumo certo nas três tentativas, e o resumo no 4.5 ficou mais barato também, porque deixou de carregar o prompt de atendimento inteiro.
O segundo tropeço foi no roteiro de diagnóstico, que segue uma ordem fixa de perguntas. Em três conversas completas, o Haiku 4.5 respeitou a ordem nas nove falas. O 5.5, no esforço low, saiu da ordem em quatro das nove, e o servidor teve de trocar a fala dele pela pergunta padrão. Em medium, foram três de nove, com resposta mais lenta. O resultado do diagnóstico continua certo, porque quem calcula é o servidor, mas a conversa fica com cara de formulário.
A decisão: a conversa e o resumo passam para o Haiku 5.5, e o diagnóstico fica no 4.5 até o roteiro ser ajustado para o modelo novo. É uma amostra pequena, de um caso só, e não substitui o teste com as suas conversas. Serve para mostrar o tipo de problema que nenhuma tabela de lançamento pega.
O que quebrou na troca foi uma tarefa de bastidor, o resumo que vai para o CRM. Ninguém olha para ela até o resumo chegar errado.
O que já foi medido fora da Anthropic
Tirando o nosso teste, que é um caso só, tudo até aqui foi publicado por quem vende. O Haiku 5.5 já tem página no nosso AI Benchmark, que reúne só medição independente, e até esta publicação o que existe é o LiveBench: média de 72,1, na 42ª posição entre 57 modelos com nota. O GPT-6 Luna tem 72,0, e o Sonnet 5.5, 77,8.
Faltam o índice composto da Epoch AI (ECI) e a nota de preferência humana da Arena, que costumam sair alguns dias depois do lançamento. Quando saírem, o modelo entra sozinho no ranking, sem ninguém digitar número. Por enquanto, no único teste amplo e independente, Haiku 5.5 e Luna estão empatados.
A comparação entre os dois Haiku fora do anúncio ainda não existe, porque o 4.5 não tem média no LiveBench. No índice da Epoch AI, o Haiku 4.5 tem 142,41, na 109ª posição entre 264 modelos, e o Luna tem 156,28, na 24ª. É essa a régua que o Haiku 5.5 vai enfrentar quando o número dele sair.
O que quebra no código de quem usa o Haiku 4.5
Trocar o nome do modelo na configuração não basta. O guia de migração da Anthropic lista as mudanças, e boa parte delas devolve erro 400 em código que funcionava ontem.
- Temperatura:
temperature,top_petop_kcom valor fora do padrão dão erro. Quem usava temperatura baixa para estabilizar a resposta precisa tirar o parâmetro. - Resposta pré-preenchida: terminar a conversa com uma mensagem do assistente para o modelo continuar dá erro, mesmo com o pensamento desligado.
- Pensamento com orçamento:
budget_tokensdá erro. O controle agora é o nível de esforço. - Uso de computador: a ferramenta antiga
computer_20250124não é aceita na API da Anthropic nem no Google Cloud. É preciso passar para o conjunto de ferramentas novo. - Recusa: o modelo tem classificadores de segurança que podem recusar o pedido, com
stop_reasonigual arefusal. No Haiku 4.5 isso não existia, e não há modelo reserva automático.
Duas mudanças não dão erro nenhum, e por isso pegam mais gente. O pensamento vem ligado por padrão e conta dentro do max_tokens, então um limite baixo, ajustado para o 4.5, pode acabar no meio do raciocínio, sem uma palavra de texto. E a resposta pode começar com blocos de raciocínio: código que lê o primeiro bloco como resposta passa a ler o lugar errado. No nosso chat, o limite subiu 30%, o pensamento ficou desligado na conversa e resposta sem texto passou a contar como falha.
Para quem usa ferramenta forçada para receber resposta em formato fixo, como nome, telefone e intenção do cliente, a notícia é boa. No Sonnet 5.5 isso virou erro 400. No Haiku 5.5 continua aceito, só que sem raciocínio antes da chamada. E dá para desligar o pensamento com disabled até o esforço high, opção que o Sonnet 5.5 também perdeu.
Segurança, e o que o relatório admite
O relatório técnico tem 144 páginas e é mais curto que os anteriores por decisão da Anthropic, que avisa que vai condensar os relatórios dos modelos fora do topo. Nos testes de risco, o Haiku 5.5 fica, no geral, abaixo do Opus 5 e não cruza nenhum limite novo da política de escala responsável da empresa.
As travas de cibersegurança são mais rígidas que as do Haiku 4.5 e mais leves que as dos outros modelos recentes. Segundo o anúncio, elas liberam mais tarefa de defesa do que as do Sonnet 5.5, mas continuam barrando teste de invasão e técnicas mais usadas por atacante.
Entre os achados menos lisonjeiros, dois importam para quem põe o modelo em produção. O excesso de recusa, que já apareceu no nosso teste. E o uso de atalho: em tarefas de programação em que a solução estava acessível no ambiente, ele usou a resposta pronta sem avisar o usuário com mais frequência que o Haiku 4.5.
Do lado bom, é o Haiku mais resistente até hoje a instruções maliciosas escondidas em página e arquivo, perto dos modelos maiores em programação e uso de computador, e foi pelo menos tão honesto sob pressão quanto todos os outros modelos testados. Em 42 idiomas, acertou em média 87,8% no Global MMLU, contra 92,1% do Sonnet 5.5. Quem mediu, de novo, foi quem vende.
O que fazer esta semana
Se você usa IA pelo aplicativo do Claude, nada muda no seu dia. Se paga Max ou Team, o crédito mensal novo serve exatamente para testar trocas como esta sem tirar dinheiro do orçamento.
Se você roda alguma coisa pela API, a sequência é esta:
- Antes de trocar, procure no código
temperature, resposta pré-preenchida,budget_tokense leitura do primeiro bloco da resposta. Os três primeiros viram erro 400; o último lê o lugar errado sem avisar. - Meça o tamanho dos seus pedidos. Se boa parte passa de 100 mil tokens, o desconto sobre o 4.5 cai para 50%, e o GPT-6 Luna fica mais barato por token.
- Refaça a conta de custo com os tokens contados no 5.5. O mesmo texto vale cerca de 30% mais tokens.
- Comece no esforço low para chat e tarefa curta, como recomenda a documentação, e só suba se a qualidade pedir. Antes de usar xhigh ou max, rode a mesma tarefa no Sonnet 5.5 em medium ou high.
- Trate a recusa no código e teste as tarefas de bastidor, como resumo, classificação e extração, com o prompt que elas usam de verdade. Foi ali que o nosso teste quebrou.
Nenhuma dessas decisões sai de tabela de lançamento. Elas saem de rodar as suas tarefas reais nos modelos candidatos e comparar acerto, custo e comportamento lado a lado, do jeito que fizemos no nosso chat. Se você tem atendimento, triagem ou extração de dados rodando com IA e quer saber quanto a troca economiza no seu caso sem quebrar nada em produção, a consultoria da ROO3 faz esse teste com as suas conversas e entrega a recomendação com número.
O que ainda não dá para dizer
Primeiro, a posição do Haiku 5.5 entre os modelos. Sem o ECI da Epoch AI e sem a nota da Arena, o dado independente que existe é um LiveBench empatado com o Luna.
Segundo, o que muda no aplicativo do Claude. Até esta publicação, a Anthropic não disse em quais planos e recursos o Haiku 5.5 substitui o 4.5. Pela API e pelas nuvens, ele está disponível para todos desde o primeiro dia.
Terceiro, a resposta da OpenAI. O Luna saiu duas semanas antes e foi igualado no preço da faixa curta, mas segue mais barato nos pedidos longos. Com a família 5.5 completa, entre o Opus 5.5, o Sonnet 5.5 e o Haiku 5.5, a escolha de fornecedor passou a depender do tamanho e do tipo do seu pedido tanto quanto do nome do modelo.
Perguntas frequentes
Quanto custa o Haiku 5.5?
Em pedidos de até 100 mil tokens: US$ 0,10 por milhão de tokens de entrada, US$ 0,50 de saída, US$ 0,01 na leitura de cache e US$ 0,125 na escrita de cache de cinco minutos (US$ 0,20 na de uma hora). Acima de 100 mil tokens, cinco vezes mais: US$ 0,50 de entrada, US$ 2,50 de saída, US$ 0,05 de leitura e US$ 0,625 de escrita de cache. Em lote, entrada e saída saem pela metade.
O Haiku 5.5 é melhor que o GPT-6 Luna?
Nos números publicados pela Anthropic, sim: ele vence as seis provas em que os dois aparecem, com a maior diferença no uso de computador (72,4% contra 48,9%). No LiveBench, que é independente, os dois estão praticamente empatados, com 72,1 contra 72,0. O preço é o mesmo até 100 mil tokens; entre 100 mil e 272 mil tokens, o Luna sai cinco vezes mais barato por token.
Haiku 5.5 ou Sonnet 5.5: qual usar?
O Sonnet 5.5 é melhor em todas as provas da tabela da Anthropic e custa 20 vezes mais por token de entrada nos pedidos de até 100 mil tokens (US$ 2 contra US$ 0,10). Para tarefa curta e de volume, como classificar, resumir, extrair e responder cliente, o Haiku resolve por uma fração do preço. Para programação complexa e tarefa longa com agentes, a própria Anthropic indica o Sonnet ou o Opus. Se o Haiku só fica bom no esforço máximo, compare com o Sonnet em high: em duas de quatro provas publicadas, o Sonnet ganhou e saiu mais barato.
O que muda no código para trocar o Haiku 4.5 pelo 5.5?
Além de trocar o identificador para claude-haiku-5-5, é preciso tirar temperature, top_p e top_k, parar de terminar a conversa com mensagem do assistente, trocar budget_tokens pelo nível de esforço e ler a resposta pelo tipo do bloco, não pela posição. Como o pensamento vem ligado e conta no max_tokens, limites baixos precisam subir. E o código precisa tratar a recusa (stop_reason refusal), que não existia no 4.5.
Por que o Haiku 5.5 fica mais caro acima de 100 mil tokens?
A Anthropic não explicou o motivo. Ela informa que 90% dos pedidos ao Haiku 4.5 tinham até 100 mil tokens, e é nessa faixa que o desconto chega a 90%. Acima dela, o Haiku 5.5 custa metade do 4.5. Na geração atual da Anthropic, é o único modelo com preço por tamanho de pedido; o Sonnet 5.5 e o Opus 5.5 cobram a mesma tabela até 1 milhão de tokens.
O Haiku 5.5 já está no AI Benchmark da ROO3?
Sim, desde o dia do lançamento, e só com medição independente. Até esta publicação ele tem a média do LiveBench, 72,1, na 42ª posição entre 57 modelos, e ainda não tem o índice composto da Epoch AI nem nota na Arena. Quando esses números saírem, ele entra sozinho no ranking.
Vale trocar o Haiku 4.5 pelo 5.5 agora?
Vale testar já, porque a conta cai muito. No chat de atendimento da ROO3, a mesma conversa custou cerca de sete vezes menos e respondeu mais rápido. Mas teste com as suas tarefas antes de trocar em produção: no nosso caso, o modelo novo recusou um resumo interno que o 4.5 fazia e seguiu menos a ordem de um roteiro fixo. As duas coisas só aparecem rodando o fluxo de verdade.
- Anthropic, anúncio do Claude Haiku 5.5 (tabela de benchmarks, gráficos de nota por custo e preços)
- Anthropic, System Card do Claude Haiku 5.5 (relatório técnico de 144 páginas)
- Claude Platform Docs, visão geral do Claude Haiku 5.5 (identificador, janela, preço e disponibilidade)
- Claude Platform Docs, guia de migração do Haiku 4.5 para o Haiku 5.5
- Claude Platform Docs, Effort (níveis de esforço e recomendação por modelo)
- Claude Platform Docs, Pricing (tabela oficial de preços da Anthropic)
- OpenAI, API pricing (preço do GPT-6 Luna, incluindo contexto longo e lote)
- LiveBench, ranking e licença CC BY-SA 4.0
Rodrigo Fávaro
Fundador da ROO3, agência de marketing e tecnologia em São José do Rio Preto. Constrói produtos com IA em produção (Tobia, gerar.app, Pense Mercado) e mantém o AI Benchmark, ranking público de modelos de IA. Veja a consultoria em IA da ROO3.
X @rodmf LinkedIn rodrigofavaroContinue lendo
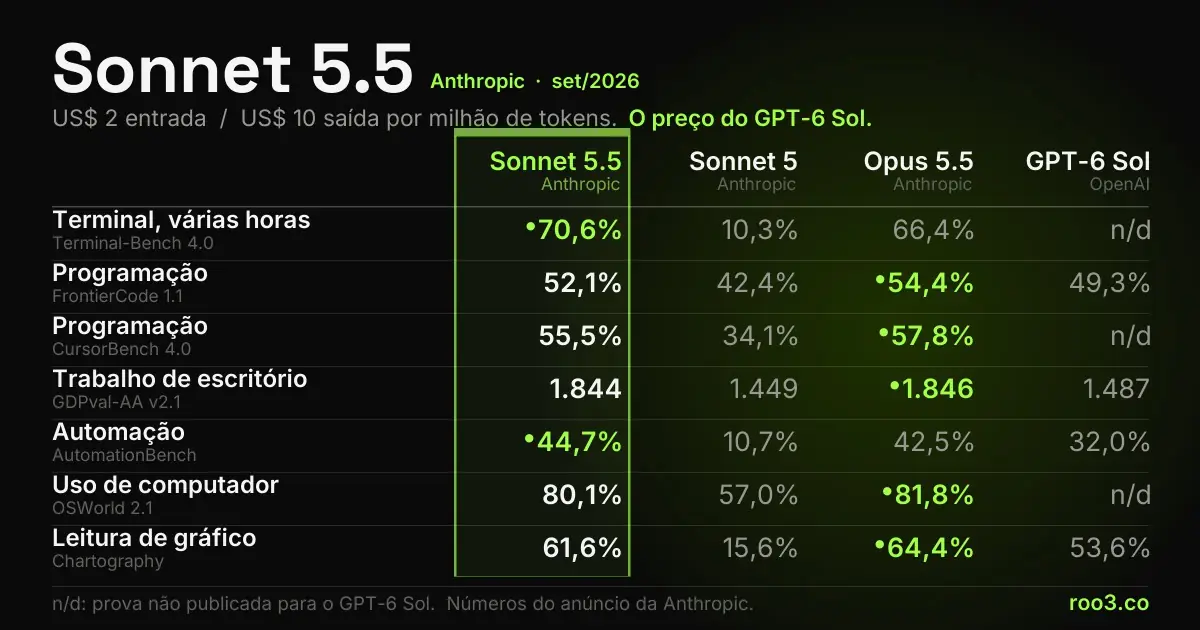
Sonnet 5.5: benchmarks, preço e o custo real por tarefa
Benchmarks do Claude Sonnet 5.5 contra Opus 5.5, Sonnet 5 e GPT-6 Sol, o preço igual ao da OpenAI e o nível de esforço...
17 min de leitura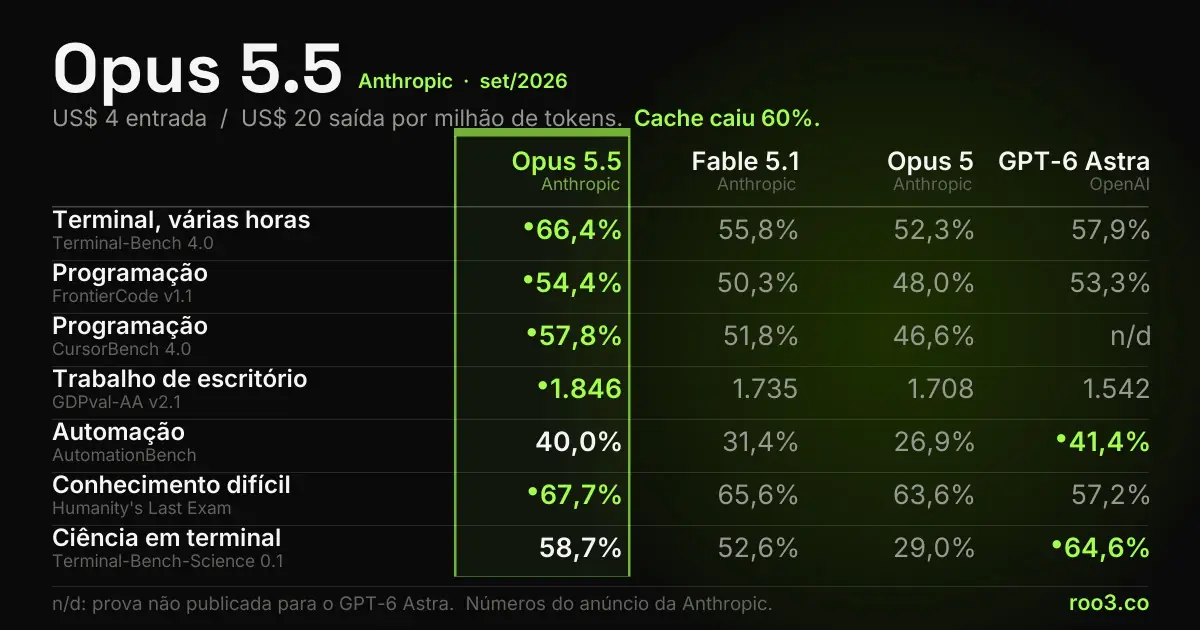
Opus 5.5: o caro ficou melhor e mais barato ao mesmo tempo
Benchmarks oficiais do Claude Opus 5.5 contra Fable 5.1, Opus 5 e GPT-6 Astra, o preço por token, a queda de 60%...
12 min de leitura
Token e janela de contexto: por que a conta da IA vem alta
O que é token, o que é janela de contexto e como a cobrança funciona de verdade. Com a conta feita e os quatro erros...
11 min de leituraQuer aplicar isso na sua empresa?
A ROO3 faz o diagnóstico do que dá para automatizar primeiro no seu negócio. A conversa inicial é gratuita.